切换至深色主题
浏览器工作设计原理
掌握浏览器工作原理的重要性
网页是通过浏览器呈现展示的,网页的整个生命周期,从加载、执行到响应,都是依赖于浏览器而实现。唯有充分运用浏览器的有效特性,同时避开浏览器对网页的约束限制等,才能更好地从本质上去优化网页的性能问题,从而带来更好的用户体验!
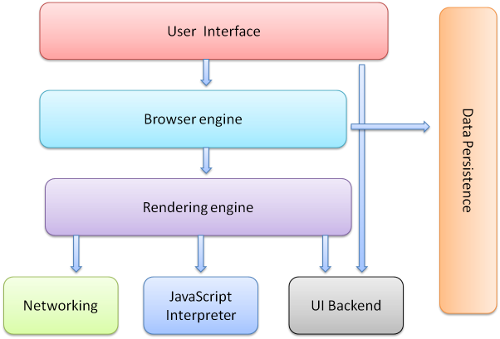
浏览器核心组件
浏览器引擎
浏览器引擎,在 UI 和渲染引擎之间编组动作。
渲染引擎
渲染引擎是单线程,负责显示请求的内容。例如,如果请求的内容是 HTML,则渲染引擎会解析 HTML 和 CSS,并将解析后的内容显示在屏幕上。Chrome等浏览器会运行多个渲染引擎实例,每个Tab选项卡运行一个,并在单独的进程中运行。
Networking
Networking,对于HTTP请求等网络调用,在一个独立于平台的接口后面使用不同平台的不同实现。
JavaScript解释器
JavaScript解释器,用于解析和执行 JavaScript 代码。
数据存储
数据存储,这是一个持久层。浏览器可能需要在本地保存各种数据,例如 cookie。浏览器还支持 localStorage、sessionStorage、IndexedDB、WebSQL 和 FileSystem 等存储机制。
浏览器进程、线程与协程
浏览器多进程与内核单进程多线程
非Chrome浏览器
开启一个浏览器,就是打开一个进程
Chrome多进程
GPU线程:最多一个,用于3D绘制等
Browser进程(主进程):负责协调、主控
第三方插件进程:每种类型的插件对应一个进程,仅当使用该插件时才创建
浏览器渲染进程:打开一个Tab页,就新开启一个进程
Browser进程:主进程
浏览器的主进程(负责协调、主控),只有一个。
负责浏览器界面显示,与用户交互。如前进,后退等
负责各个页面的管理,创建和销毁其他进程
将Renderer进程得到的内存中的Bitmap,绘制到用户界面上
网络资源的管理,下载等
备注
GUI渲染线程与JS引擎线程互斥:当JS引擎执行时GUI线程会被挂起
问题:由于JavaScript是可操纵DOM的,如果在修改这些元素属性同时渲染界面(即JS线程和UI线程同时运行),那么渲染线程前后获得的元素数据就可能不一致了
定时器线程
setTimeout 和 setInterval 都是挂在定时器触发线程下面, 也是需要等待执行栈的完成之后才能执行
浏览器内核:浏览器渲染进程,单进程、多线程
JS引擎线程:JS处理,V8引擎 界面渲染线程: 事件触发线程: http请求线程:
进程 Process
进程是操作系统分配资源的最小单位,是应用程序的启动实例,一个进程中有多个执行流称作多线程,一个进程至少包含一个主线程,也可以有更多的子线程。
浏览器进程
负责界面显示、用户交互、子进程与存储等管理。
渲染进程
负责网页的渲染工作,例如Chrome会为每一个Tab选项卡创建一个渲染进程,渲染网页内容。
GPU 进程
负责GPU的渲染机制。
网络进程
负责网络资源的请求加载。
插件进程
负责管理运行浏览器的插件模块。
线程 Thread
线程是同时运行多个任务或程序的执行,每个能够执行代码的单元称为线程。
线程是程序执行的最小单位,一条线程指的是进程中一个单一顺序的控制流,一个进程中可以并发多个线程。
每条线程并行执行不同的任务,线程拥有自己的栈空间。一个线程也可以拥有多个协程。
主线程
主线程是浏览器用来处理用户事件、渲染和绘制显示以及运行组成典型网页或应用程序的大部分代码的线程,例如解析和执行 HTML、CSS 和 JavaScript。
协程 Coroutine
协程,又称微线程,是一种用户态的轻量级线程,协程的调度完全由用户控制,但某一时刻只能有一个协程在运行,多个协程分享该线程分配到的计算机资源。
主线程
主线程是浏览器用来处理用户事件、页面渲染和绘制显示以及运行组成典型网页或应用程序的大部分代码的线程,例如解析和执行 HTML、CSS 和 JavaScript。默认情况下,浏览器在一个线程中运行一个页面中的所有 JavaScript 脚本,以及呈现布局,回流,和垃圾回收。
主线程
所谓的单线程,是指在JS引擎中负责解释和执行JavaScript代码的线程只有一个。我们称它主线程。
工作线程
处理AJAX请求的线程、处理DOM事件的线程、定时器线程、读写文件的线程(例如在Node.js中)等等。我们称它们工作线程。
重要通知
可以使用 web worker在后台线程中运行脚本,后台线程可以执行任务而不干扰用户界面。
注意事项
由于你的代码和浏览器的用户界面运行在同一个线程中,共享同一个事件循环,假如你的代码阻塞了或者进入了无限循环,则浏览器将会卡死。
- 除非故意使用 web worker,比如 service worker,不然 JavaScript 只在线程中运行,所以脚本的运行时,很容易导致事件处理流程或绘制的延迟。主线程中运行的工作越少,就有越多的余地来处理用户事件,页面绘制和对用户保持响应。
同步式I/O
线程在执行中如果遇到磁盘读写或者网络通信(统称为I/O操作),通常要耗费较长的时间,这是操作系统会剥夺这个线程的CPU控制权,使其暂停执行,同时将资源让给其他的工作线程,这种线程的调度方式称为阻塞。当I/O操作结束,操作系统将这个线程的阻塞状态解除,恢复其对CPU的控制权,令其继续执行。这种I/O模式就是我们通常说的同步式I/O。
多线程+同步式I/O
一个线程同时只能处理一项任务,并且I/O操作往往比CPU计算要耗时得多,所以在同步式I/O模式下,当I/O操作执行时,线程被阻塞,CPU处于空闲的状态,如果要提高CPU的利用率,必须通过多线程,一个线程因为同步式I/O被阻塞了,还有其它线程在工作,多线程可以让CPU资源不被阻塞中的线程浪费,这也是众多多线程语言采用的模式。
异步式I/O
异步式I/O是针对上述的I/O操作,不采用阻塞模式,当线程遇到I/O操作时,不会以阻塞的方式等待I/O操作的结束,而只是将I/O操作请求发送给操作系统,然后继续执行下一条语句。当操作系统完成I/O操作,以事件的形式通知执行I/O操作的线程,线程会在特定的时间处理这个事件
任务
同步任务指的是,在主线程上排队执行的任务,只有前一个任务执行完毕,才能执行后一个任务; 异步任务指的是,暂时不进入主线程而是进入消息队列的任务,只有主线程的同步任务全部结束后该任务才会进入主线程执行。 工作线程将消息放到消息队列,主线程通过事件循环去取消息。
所有同步任务都在主线程上执行,形成一个执行栈(execution context stack)。 主线程之外,还存在一个消息队列。只要异步任务有了运行结果,就在消息队列之中放置一个事件。 一旦"执行栈"中的所有同步任务执行完毕,系统就会读取消息队列,看看里面有哪些事件。那些对应的异步任务结束等待状态,进入执行栈,开始执行。 主线程只会做一件事情,就是从消息队列里面取消息、执行消息,再取消息、再执行,不断重复上面的第三步。
宏任务(macro-task)、微任务(micro-task)、正常任务(task) macro-task: setTimeout、setInterval、setImmediate、I/O, UI rendering等 micro-task: process.nextTick、Promises.then、Object.observe等
浏览器的工作原理
导航是加载 web 页面的第一步。它发生在以下情形:用户通过在地址栏输入一个 URL、点击一个链接、提交表单或者是其他的行为。
浏览器的工作原理:https://www.html5rocks.com/en/tutorials/internals/howbrowserswork/https://webkit.org/ 高性能浏览器网络:https://hpbn.co/?utm_source=igvita&utm_medium=referral&utm_campaign=igvita-homepage 浏览器的工作原理:https://developer.mozilla.org/zh-CN/docs/Web/Performance/How_browsers_work 浏览器的工作原理:https://www.html5rocks.com/zh/tutorials/internals/howbrowserswork/ 浏览器的工作原理:https://developer.mozilla.org/zh-CN/docs/Web/Performance/How_browsers_work 从浏览器多进程到JS单线程,JS运行机制最全面的一次梳理:https://cloud.tencent.com/developer/article/1547827
https://html.spec.whatwg.org/multipage/parsing.html
网络的连接原理
一、生成HTTP请求消息 二、向DNS服务器查询Web服务器的IP地址 三、浏览器委托协议栈发送消息 四、IP与以太网的包收发操作 五、集线器、交换机、路由器 六、探索接入网和网络运营商(没有深入了解) 七、服务器端的局域网中有什么玄机 八、请求到达Web服务器,响应返回浏览器
浏览器对URL的长度限制
1. IE浏览器对URL的长度现限制为2048字节。 2. 360极速浏览器对URL的长度限制为2118字节。 3. Firefox(Browser)对URL的长度限制为65536字节。 4. Safari(Browser)对URL的长度限制为80000字节。 5. Opera(Browser)对URL的长度限制为190000字节。 6. Google(chrome)对URL的长度限制为8182字节。
HTTP请求
GET请求
是HTTP协议中实现的请求方法,基于TCP/IP协议。
POST请求
是HTTP协议中实现的请求方法,基于TCP/IP协议。
GET产生一个TCP数据包;POST产生两个TCP数据包 对于GET方式的请求,浏览器会把http header和data一并发送出去,服务器响应200(返回数据); 而对于POST,浏览器先发送header,服务器响应100 continue,浏览器再发送data,服务器响应200 ok(返回数据)。 并不是所有浏览器都会在POST中发送两次包,Firefox就只发送一次
HTTP中进行语义化的八种方法
1、OPTIONS 返回服务器针对特定资源所支持的HTTP请求方法,也可以利用向web服务器发送‘*’的请求来测试服务器的功能性 2、HEAD 向服务器索与GET请求相一致的响应,只不过响应体将不会被返回。这一方法可以再不必传输整个响应内容的情况下,就可以获取包含在响应小消息头中的元信息。 3、GET 向特定的资源发出请求。它本质就是发送一个请求来取得服务器上的某一资源。资源通过一组HTTP头和呈现数据(如HTML文本,或者图片或者视频等)返回给客户端。GET请求中,永远不会包含呈现数据。 4、POST 向指定资源提交数据进行处理请求(例如提交表单或者上传文件)。数据被包含在请求体中。POST请求可能会导致新的资源的建立和/或已有资源的修改。 Loadrunner中对应POST请求函数:web_submit_data,web_submit_form 5、PUT 向指定资源位置上传其最新内容 6、DELETE 请求服务器删除Request-URL所标识的资源 7、TRACE 回显服务器收到的请求,主要用于测试或诊断 8、CONNECT HTTP/1.1协议中预留给能够将连接改为管道方式的代理服务器。
HTTP历史版本
DNS 查询
DNS 查询可能存在性能问题,特别是对于移动网络。当一个用户使用了移动网络,每一个 DNS 查询必须从手机发送到基站,然后到达一个认证的 DNS 服务器。手机、信号塔、名称服务器之间的距离可能是一个大的时间等待。
TCP 握手
一旦获取到服务器 IP 地址,浏览器就会通过 TCP “三次握手” (en-US)与服务器建立连接。这个机制的是用来让两端尝试进行通信——在浏览器和服务器通过上层协议 HTTPS 发送数据之前,可以协商网络 TCP 套接字连接的一些参数。
TLS 协商
TLS协商需要经历建立TLS连接的四次握手,在发送真正的请求内容之前还需要三次往返服务器,经过 8 次往返,浏览器终于可以发出请求。
响应反馈
一旦我们建立了到 web 服务器的连接,浏览器就代表用户发送一个初始的 HTTP GET 请求,对于网站来说,这个请求通常是一个 HTML 文件。一旦服务器收到请求,它将使用相关的响应头和 HTML 的内容进行回复。
注意事项
当下载HTML 文件完成后,直到浏览器在解析阶段遇到链接时才会去请求链接的资源。
网页解析
一旦浏览器收到数据的第一块,它就可以开始解析收到的信息。“解析”是浏览器将通过网络接收的数据转换为 DOM 和 CSSOM 的步骤,通过渲染器把 DOM 和 CSSOM 在屏幕上绘制成页面。
注意事项
即使请求页面的 HTML 大于初始的 14KB 数据包,浏览器也将开始解析并尝试根据其拥有的数据进行渲染。这就是为什么在前 14KB 中包含浏览器开始渲染页面所需的所有内容,或者至少包含页面模板(第一次渲染所需的 CSS 和 HTML )对于 web 性能优化来说是重要的。但是在渲染到屏幕上面之前,HTML、CSS、JavaScript 必须被解析完成。
预加载扫描器
浏览器构建 DOM 树时,这个过程占用了主线程。当这种情况发生时,预加载扫描仪将解析可用的内容并请求高优先级资源,如 CSS、JavaScript 和 web 字体。多亏了预加载扫描器,我们不必等到解析器找到对外部资源的引用来请求它。它将在后台检索资源,以便在主 HTML 解析器到达请求的资源时,它们可能已经在运行,或者已经被下载。预加载扫描仪提供的优化减少了阻塞。
渲染
渲染步骤包括样式、布局、绘制,在某些情况下还包括合成。在解析步骤中创建的 CSSOM 树和 DOM 树组合成一个 Render 树,然后用于计算每个可见元素的布局,然后将其绘制到屏幕上。在某些情况下,可以将内容提升到它们自己的层并进行合成,通过在 GPU 而不是 CPU 上绘制屏幕的一部分来提高性能,从而释放主线程。
交互
一旦主线程绘制页面完成,如果加载包含 JavaScript(并且延迟到 onload 事件激发后执行),则主线程可能很忙,无法用于滚动、触摸和其他交互。
Web 存储机制
缓存是介于应用程序和物理数据源之间,其作用是为了降低应用程序对物理数据源访问的频次,从而提高了应用的运行性能。缓存内的数据是对物理数据源中的数据的复制,应用程序在运行时从缓存读写数据,在特定的时刻或事件会同步缓存和物理数据源的数据。
注意事项
每个浏览器都硬性限制了一个域下缓存数据的大小。缓存配额使用估算值,可以使用 StorageEstimate API 获得。
StorageManager
Storage API的StorageManager接口提供了用于管理数据本地存储权限和估算可用存储空间的接口。 您可以使用navigator.storage或WorkerNavigator.storage对此接口进行引用。
注意事项
此项功能仅在安全上下文(HTTPS), 一些 支持的浏览器。
- StorageManager.estimate():计算目前所使用的存储空间占全部存储空间的百分比。
navigator.storage.estimate().then(function(estimate) {
  const value = (estimate.usage / estimate.quota * 100).toFixed(2);
  console.log(estimate.usage); // 此应用(或域名)已用的存储空间
  console.log(estimate.quota); // 此应用(或域名)可用的存储空间
  console.log(estimate.usageDetails);
});- StorageManager.persist():请求本地数据存储的权限,一个 resolved 状态,值为Boolean类型的Promise对象。如果被拒绝则返回false,否则返回true。
navigator.storage.persist().then(function(persistent) {
  console.log(persistent);
});- StorageManager.persisted():如果盒存储模式(box mode)的值为 “persistent” 则返回一个 resolved 状态值为true的Promise。
navigator.storage.persisted().then(function(persistent) {
  console.log(persistent);
});
HTTP缓存
HTTP 缓存是接收 HTTP(S) 请求并决定何时以及如何从磁盘缓存或网络获取数据的模块,且缓存存在于浏览器进程中,作为网络堆栈的一部分。
Web 缓存减少了等待时间和网络流量,因此减少了显示资源表示形式所需的时间。通过使用 HTTP 缓存,变得更加响应性。
缓存是一种保存资源副本并在下次请求时直接使用该副本的技术。
注意事项
本文主要介绍浏览器与代理缓存。但是,除此之外还有网关缓存、CDN、反向代理缓存和负载均衡器等部署在服务器上的缓存方式。
(私有) 浏览器缓存
私有缓存只能用于单独用户。浏览器缓存拥有用户通过 HTTP 下载的所有文档。这些缓存为浏览过的文档提供向后/向前导航,保存网页,查看源码等功能,可以避免再次向服务器发起多余的请求。它同样可以提供缓存内容的离线浏览。
(共享) 代理缓存
共享缓存可以被多个用户使用。例如,ISP 或你所在的公司可能会架设一个 Web 代理来作为本地网络基础的一部分提供给用户。这样热门的资源就会被重复使用,减少网络拥堵与延迟。
强缓存
命中强缓存时,浏览器并不会将请求发送给服务器。在Chrome的开发者工具中看到http的返回码是200,但是在Size列会显示为(from cache)。
协商缓存
若未命中强缓存,则浏览器会将请求发送至服务器, 服务器根据http头信息中的Last-Modify/If-Modify-Since或Etag/If-None-Match来判断是否命中协商缓存,如果命中,则http返回码为304,浏览器从缓存中加载资源。
浏览器缓存Size显示类型
200(from disk cache):资源缓存在内存中,浏览器关闭后生命周期结束
200(from memory cache):资源缓存在硬盘中
200(from ServiceWorker):PWA部署缓存
304(Not Modified):向服务器发起网络请求,服务器来判断浏览器本地缓存有效,则服务器不返回资源,浏览器继续从缓存中加载资源
浏览器 Web网页设置缓存策略
<!--禁止浏览器从本地计算机的缓存中访问页面内容-->
<meta http-equiv="Pragma" content="no-store">
<meta http-equiv="Cache" content="no-cache">
<!--网页到期时间-->
<meta http-equiv="expires" content="Wed, 20 Jun 2020 22:33:00 GMT" />
<meta http-equiv="Cache-control" content="no-cache">
<!--
  no-cache,协商缓存,浏览器和缓存服务器都不应该缓存页面信息;
  public,浏览器和缓存服务器都可以缓存页面信息;
  no-store,不缓存,请求和响应的信息都不应该被存储在对方的磁盘系统中;
  must-revalidate,过期强制请求服务器,每次请求,代理服务器必须想服务器验证缓存是否过时;
-->
Nginx Web网页设置缓存策略
location ~ .*\.(htm | html | png | css | js)$ {
  expires 24h;
  root  /opt/app/code;
}
配额与现额
- 最大存储配额
- 当前存储大小
内存管理与垃圾回收
内存(Memory)是计算机的重要部件,也称内存储器和主存储器,它用于暂时存放CPU中的运算数据,以及与硬盘等外部存储器交换的数据。
注意事项
内存的运行决定计算机整体运行快慢。
JS内存空间
- 栈(stack):存放变量。
- 堆(heap):存放复杂对象。
- 池:存放常量,一般也会归类为栈中。
内存的生命周期
- 内存分配:当我们申明变量、函数、对象的时候,系统会自动为他 们分配内存
- 内存使用:即读写内存,也就是使用变量、函数等
- 内存回收:使用完毕,由垃圾回收机制自动回收不再使用的内存
GC垃圾回收机制
- 标记清除:垃圾收集器在运行的时候会给存储在内存中的所有变量都加上标记,然后,它会去掉环境中的变量的标记和被环境中的变量引用的变量的标记,此后,如果变量再被标记则表示此变量准备被删除。
- 引用计数(现代浏览器不再使用):跟踪记录每个值被引用的次数,当声明一个变量并将一个引用类型的值赋给该变量时,这个值的引用次数就是1,如果这个值再被赋值给另一个变量,则引用次数加1。相反,如果一个变量脱离了该值的引用,则该值引用次数减1,当次数为0时,就会等待垃圾收集器的回收。
- V8实现:每次 GC 时,是根据 root 对象 (浏览器环境下的 window,Node.js 环境下的 global ) 依次梳理对象的引用,如果能从 root 的引用链到达访问,V8 就会将其标记为可到达对象,反之为不可到达对象。被标记为不可到达对象(即无引用的对象)后就会被 V8 回收。
mark-and-sweep 算法
V8采用传统的 mark-and-sweep 算法 来清理旧一代。 标记阶段应该停止JavaScript执行。 为了控制GC成本并使执行更稳定,V8使用增量标记:不是遍历整个堆,尝试标记每个可能的对象,它只是遍历堆的一部分,然后恢复正常执行。下一个GC停止将从上一个堆行走停止的位置继续,这允许在正常执行期间非常短暂的暂停,如前所述,扫描阶段由单独的线程处理。
标记-清除算法
这个算法假定设置一个叫做根(root)的对象(在Javascript里,根是全局对象)。垃圾回收器将定期从根开始,找所有从根开始引用的对象,然后找这些对象引用的对象……从根开始,垃圾回收器将找到所有可以获得的对象和收集所有不能获得的对象。
内存泄漏
执行完任务的变量一直保存在内存中而未被清除,消耗内存。
内存泄漏的几种情况
- 全局变量
- 合理规划全局变量的声明与使用
- 闭包
- 谨慎处理闭包引入与内存管理
- 事件监听
- 注意事件解绑的同步
- 控制台输出信息
- 尽量控制生产环境去掉控制台输出语句
内存泄漏分析
- 使用 Chrome DevTools 堆分析器记录堆快照并查找内存泄漏,Chrome DevTools 堆分析器按页面的 JavaScript 对象和相关 DOM 节点显示内存分布,使用它来拍摄 JS 堆快照、分析内存图、比较快照和查找内存泄漏。
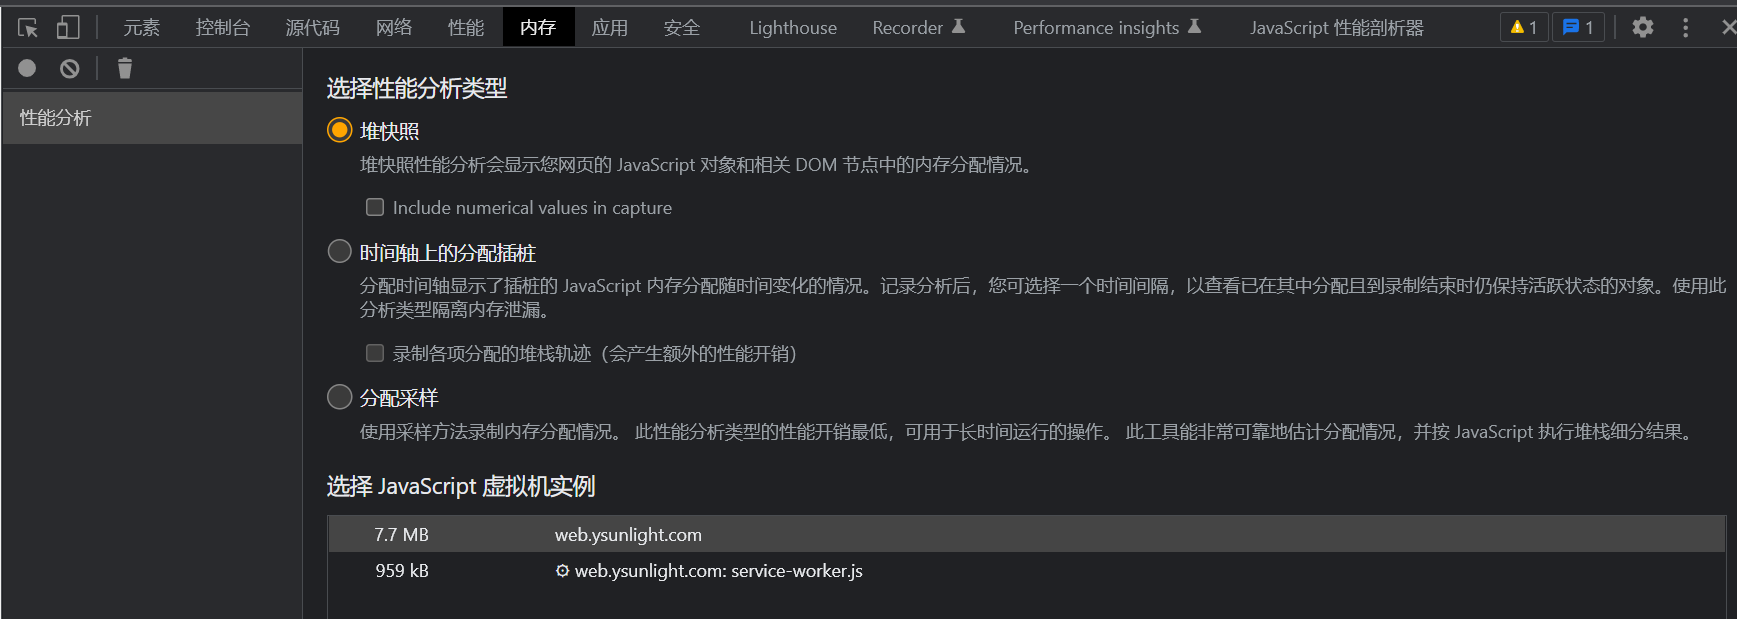
- 触发"拍摄堆快照",将快照加载到 DevTools 并进行解析后,快照标题下方的数字会出现,并显示可访问的 JavaScript 对象的总大小。
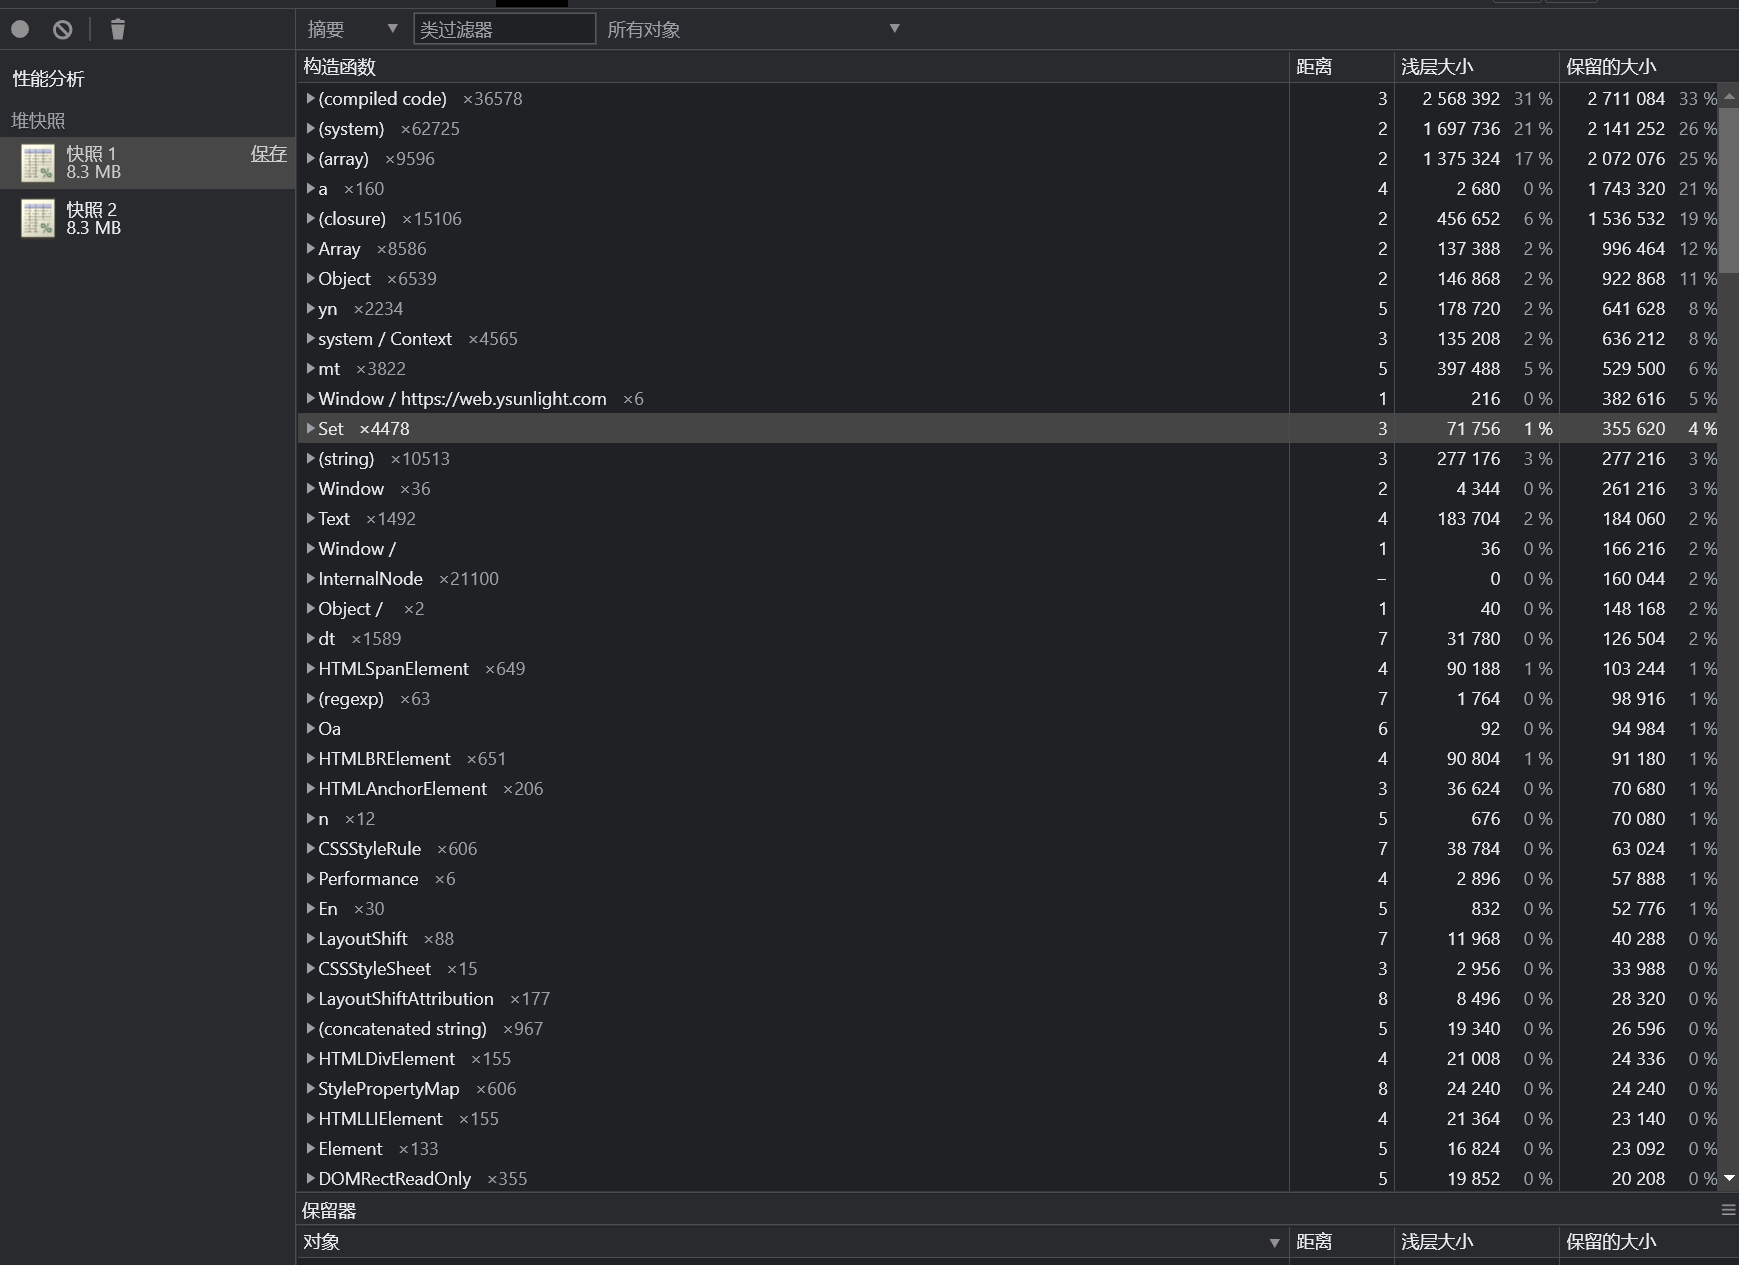
从不同角度查看不同任务的快照
- 摘要视图:显示按构造函数名称分组的对象。使用它根据按构造函数名称分组的类型来搜索对象(及其内存使用)。它对于追踪 DOM 泄漏特别有帮助。
- 比较视图:显示两个快照之间的差异,使用它来比较操作前后的两个(或多个)内存快照,检查释放内存和引用计数中的增量可让您确认内存泄漏的存在和原因。
- 控制视图
- 统计信息视图
快照信息
- 构造函数:表示使用此构造函数创建的所有对象。
- 全局属性:全局对象和它引用的对象之间的中间对象。
- 闭包(closure):通过函数闭包对一组对象的引用计数。
- 对象类型列表:具有引用数组、字符串、数字或正则表达式的属性。
- 编译代码:与编译代码相关的一切。脚本类似于函数,但对应于
<script>主体。SharedFunctionInfos (SFI) 是位于函数和编译代码之间的对象。函数通常有上下文,而 SFI 没有。 - HTMLDivElement、HTMLAnchorElement、DocumentFragment等——对代码引用的特定类型的元素或文档对象的引用。
- 对象实例的数量:即构造函数的实际实例总数。
- 距离:使用最短的简单节点路径显示到根的距离。
- 浅层大小:显示由某个构造函数创建的所有对象的浅尺寸总和。浅层大小是对象本身持有的内存大小(通常,数组和字符串具有较大的浅层大小)。
- 保留大小:显示同一组对象中的最大保留大小。一旦对象被删除(并且其依赖项不再可访问)可以释放的内存大小称为保留大小。